Escritura
SWE-bench Verified como instrumento: TCT y TRI con datos a nivel reactivo
Por qué mirar un benchmark como un test
Cada vez que se anuncia un nuevo modelo de lenguaje aparece, casi sin falta, la frase «X% en SWE-bench Verified», y se lee, y se repite, y se presume, como si fuera una medida de qué tanto sabe un sistema de ingeniería de software. Lo cierto es que esa frase, en términos de los Standards for Educational and Psychological Testing (AERA, APA y NCME, 2014), es una interpretación de puntajes, y como cualquier interpretación de puntajes necesita evidencias de validez que la respalden, evidencias que, a mi parecer, rara vez acompañan a la cifra. Considero que vale la pena, entonces, hacer con este benchmark lo que haríamos con cualquier otra prueba, es decir, mirarlo como un test y preguntarle lo que se le pregunta a un test.
Para quien viene del mundo de la IA, quizá valga la pena decir en pocas líneas qué es eso de la psicometría. Es la disciplina que se ocupa de medir lo que no se puede observar directamente, como una habilidad o una actitud, a partir de las respuestas a una prueba, y lleva más de un siglo preguntándose, precisamente, cuándo un puntaje significa lo que decimos que significa. Sus herramientas se pensaron para personas, pero considero que pueden aplicarse, con algunas precauciones, a los modelos, pues un benchmark es, a fin de cuentas, una prueba, con sus reactivos, su regla de calificación y su puntaje total. Y para quien viene de la psicometría, lo novedoso aquí es el examinado, un sistema compuesto por un modelo, un andamiaje y un presupuesto de cómputo, con todo lo que eso implica para supuestos como la independencia entre examinados.
Los Standards distinguen varias fuentes de evidencia, y en esta entrada me ocupo solo de una, la estructura interna (Estándar 1.13), pues es la que se puede estudiar con los datos que el propio benchmark publica, que son, quizá, lo más valioso que tiene. Quería saber si los 500 reactivos se comportan como indicadores de un mismo atributo, qué tan bien distingue la prueba entre los sistemas que hoy compiten hasta arriba de la tabla y si hay reactivos que, por así decirlo, juegan en contra del puntaje total. Las demás fuentes de evidencia, el contenido, los procesos de respuesta, las relaciones con otras variables y las consecuencias, junto con el problema de la contaminación, las reviso en la entrada compañera, Ficha de validez: SWE-bench Verified.
Algunas precisiones de vocabulario para leer lo que sigue:
- Reactivo: una tarea de SWE-bench Verified (un issue real de un repositorio de Python con sus pruebas de aceptación). Solo uso los
instance_id; no reproduzco el contenido de los reactivos.
- Examinado: un envío al leaderboard, es decir, un sistema = modelo + andamiaje (scaffold) + presupuesto de cómputo/intentos. Un mismo modelo aparece varias veces con andamiajes distintos.
- Respuesta correcta: el reactivo quedó resuelto (las pruebas que deben pasar pasan y las que ya pasaban siguen pasando). Todo lo demás, incluido “no generó parche”, se codifica como 0, que es la misma regla con la que el leaderboard calcula el porcentaje sobre un denominador fijo de 500.
Datos
Fuente y criterios de inclusión
Los datos provienen del repositorio público SWE-bench/experiments, que guarda un directorio por envío en evaluation/verified/. Para cada envío se leyeron metadata.yaml y la lista de reactivos resueltos, que está en results/results.json (envíos tradicionales) o en per_instance_details.json (corridas de la tabla bash-only con mini-SWE-agent). El script preparar_datos.py reconstruye los dos CSV de esta carpeta a partir de un clon parcial del repositorio (commit 40f164d, del 3 de septiembre de 2026); al renderizar, esta entrada no descarga nada.
Criterios:
- Se incluyen los envíos con resultados por reactivo.
- Cuando
metadata.yaml declara un porcentaje resuelto, el conteo por reactivo debe coincidir con él (tolerancia de 1 punto porcentual). Es un control mínimo de integridad del archivo.
- Se buscaron envíos duplicados o casi idénticos (distancia de Hamming entre vectores de respuesta ≤ 10 reactivos) para eliminarlos o marcarlos. Las versiones repetidas de un mismo modelo con andamiajes distintos se conservan, porque son examinados distintos, aunque no independientes (ver Limitaciones).
Ver código
library(tidyverse)
library(mirt)
library(psych)
library(gt)

respuestas <- read_csv("respuestas_swebench_verified.csv", show_col_types = FALSE)
envios_todos <- read_csv("envios_swebench_verified.csv", show_col_types = FALSE)

envios <- envios_todos %>%
  filter(incluido == 1) %>%
  mutate(
    fecha = as.Date(fecha),
    familia = case_when(
      agente == "RAG baseline" ~ "Línea base RAG (2023-2024)",
      mini_swe_agent == 1      ~ "mini-SWE-agent (bash-only)",
      TRUE                     ~ "Otros agentes"
    )
  )

X <- as.matrix(respuestas[, -1])
rownames(X) <- respuestas$envio
stopifnot(identical(rownames(X), envios$envio))

repo_de <- function(id) sub("__.*", "", id)

## Tabla estilo APA
apa <- function(x, title = " ", ...) {
  gt(x, ...) %>%
    tab_options(
      table.border.top.color = "transparent",
      heading.title.font.size = px(16),
      column_labels.border.top.width = 3,
      column_labels.border.top.color = "black",
      column_labels.border.bottom.width = 3,
      column_labels.border.bottom.color = "black",
      table_body.border.bottom.color = "black",
      table.border.bottom.color = "transparent",
      table.width = pct(100),
      table.background.color = "transparent"
    ) %>%
    cols_align(align = "center") %>%
    tab_style(
      style = list(
        cell_borders(sides = c("top", "bottom"), color = "transparent", weight = px(1)),
        cell_text(align = "center"),
        cell_fill(color = "transparent", alpha = NULL)
      ),
      locations = cells_body(columns = everything(), rows = everything())
    ) %>%
    tab_header(title = gt::html("<i>", title, "</i>")) %>%
    opt_align_table_header(align = "left")
}

## Paleta (una por rol, siempre en el mismo orden)
col_familia <- c("Línea base RAG (2023-2024)" = "#eb6834",
                 "mini-SWE-agent (bash-only)" = "#1baf7a",
                 "Otros agentes"              = "#2a78d6")
tema <- theme_minimal(base_size = 11) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title.position = "plot",
        plot.background = element_rect(fill = "transparent", colour = NA))
Ver código
excluidos <- envios_todos %>% filter(incluido == 0)
n_carpetas <- nrow(envios_todos)
n_sin_datos <- sum(grepl("sin datos", excluidos$motivo_exclusion))
n_incons <- sum(grepl("inconsistente", excluidos$motivo_exclusion))

excluidos %>%
  transmute(Envío = envio,
            Motivo = stringr::str_replace_all(
              motivo_exclusion,
              c("por ítem" = "por reactivo", " vs " = " frente a "))) %>%
  apa("Tabla 1. Envíos excluidos")
| Envío |
Motivo |
| 20250720_mini-v0.0.0-Llama-4-Scout-17B-Instruct |
sin datos por reactivo |
| 20250720_mini-v0.0.0-claude-3-7-sonnet-20250219 |
inconsistente: 51/500 por reactivo frente a 52.8% declarado |
| 20250720_mini-v0.0.0-gpt-4o-2024-11-20 |
sin datos por reactivo |
| 20250720_mini-v0.0.0_gpt-4.1-mini-2025-04-14 |
sin datos por reactivo |
| 20250726_mini-v1.0.0_gemini-2.0-flash |
sin datos por reactivo |
| 20250726_mini-v1.0.0_gemini-2.5-flash |
sin datos por reactivo |
| 20250726_mini-v1.0.0_gpt-4.1-2025-04-14 |
sin datos por reactivo |
| 20260219_mini-v2.0.0_gpt-5-2-codex |
sin datos por reactivo |
| 20260226_mini-v2.0.0_gemini-3-pro-high |
inconsistente: 0/500 por reactivo frente a 69.6% declarado |
De 182 carpetas de envío en evaluation/verified/, 7 no traen resultados por reactivo y 2 tienen un archivo por reactivo que no reproduce el porcentaje declarado (en un caso, el archivo marca 0 reactivos resueltos cuando el envío declara cerca del 70%). La matriz final tiene 173 examinados × 500 reactivos.
Ver código
## Distancia de Hamming entre todos los pares de envíos
D <- as.matrix(dist(X, method = "manhattan"))  # con datos 0/1 = Hamming
pares <- which(upper.tri(D) & D <= 10, arr.ind = TRUE)
tot_pares <- cbind(rowSums(X)[pares[, 1]], rowSums(X)[pares[, 2]])
## Distancia mínima entre envíos que resuelven al menos 50 reactivos
sub50 <- rowSums(X) >= 50
D50 <- D[sub50, sub50]
d_min50 <- min(D50[upper.tri(D50)])
Hay 3 pares de envíos a distancia ≤ 10, todos entre sistemas que resuelven 7 reactivos o menos, donde la coincidencia es trivial (casi todo es 0). Entre los envíos que resuelven al menos 50 reactivos, la distancia mínima es de 13 reactivos, así que no se eliminó ningún envío por duplicado.
Ver código
envios %>%
  count(familia, intentos = ifelse(is.na(intentos), "sin dato", intentos)) %>%
  pivot_wider(names_from = intentos, values_from = n, values_fill = 0) %>%
  rename(Familia = familia) %>%
  apa("Tabla 2. Examinados por familia y número de intentos declarados")
| Familia |
1 |
2+ |
2 |
sin dato |
| Línea base RAG (2023-2024) |
4 |
2 |
0 |
0 |
| Otros agentes |
40 |
79 |
1 |
8 |
| mini-SWE-agent (bash-only) |
39 |
0 |
0 |
0 |
La columna de intentos importa: “2+” indica que el sistema generó varias soluciones candidatas y eligió una. Para la matriz sigue siendo una respuesta dicotómica por reactivo, pero el examinado es otro: un sistema con selección entre candidatos.
Distribución de puntajes
Ver código
p <- colMeans(X)
total <- rowSums(X)
envios$total <- total

n_p0 <- sum(p == 0)
n_p1 <- sum(p == 1)
n_raros <- sum(p > 0 & p <= 0.02)
Ver código
ggplot(envios, aes(fecha, total, colour = familia)) +
  geom_point(size = 2.2, alpha = .85) +
  scale_colour_manual(values = col_familia, name = NULL) +
  scale_y_continuous(limits = c(0, 500), breaks = seq(0, 500, 100)) +
  labs(x = "Fecha del envío", y = "Reactivos resueltos") +
  tema
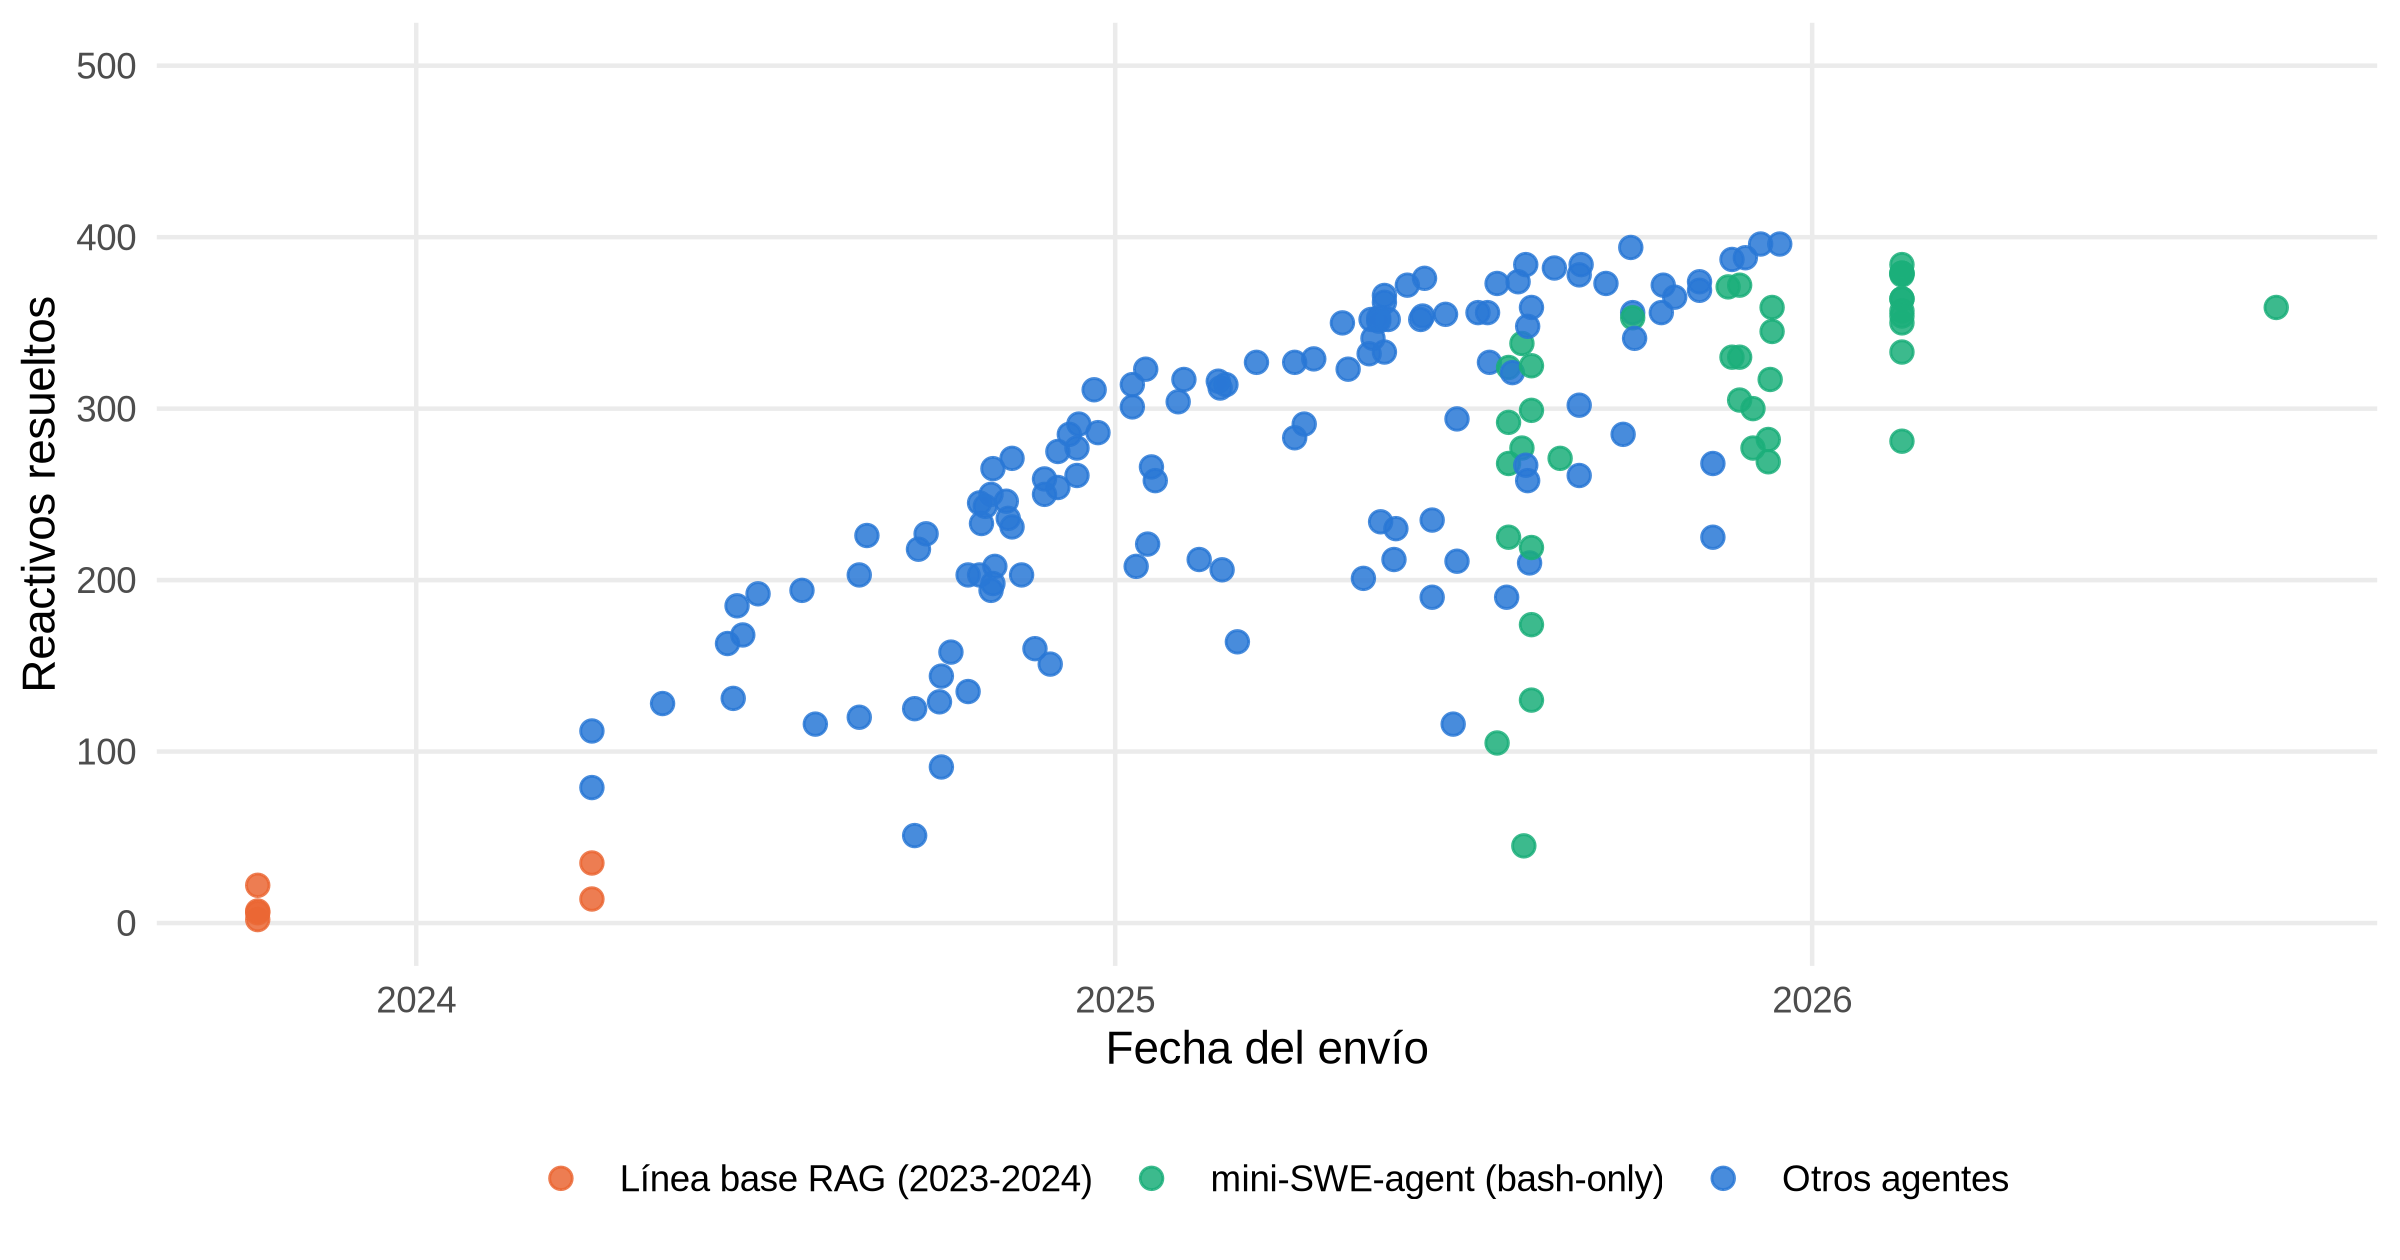
El puntaje mediano es 283 (56.6%), con rango de 2 a 396. El máximo observado equivale a 79.2% de la prueba. La mitad central de los envíos está entre 208 y 352 reactivos resueltos. La distribución está lejos de ser una muestra de una población: hay un pequeño grupo de líneas base sin agente (RAG, 2023-2024) casi en el piso y una masa de sistemas agénticos que crece con el tiempo hacia la parte alta de la escala.
Análisis clásico (TCT)
Ver código
## Reactivos con varianza (los de p = 0 o p = 1 no aportan información)
Xv <- X[, p > 0 & p < 1]
k <- ncol(Xv)
tot_v <- rowSums(Xv)

kr20 <- function(M) {
  pj <- colMeans(M)
  ncol(M) / (ncol(M) - 1) * (1 - sum(pj * (1 - pj)) / var(rowSums(M)))
}
KR20 <- kr20(Xv)

## Correlación punto-biserial reactivo-total corregida
r_itc <- sapply(seq_len(k), function(j) cor(Xv[, j], tot_v - Xv[, j]))
names(r_itc) <- colnames(Xv)

## p en el cuartil inferior y superior del puntaje total
q_bajo <- tot_v <= quantile(tot_v, .25)
q_alto <- tot_v >= quantile(tot_v, .75)

clasico <- tibble(
  item   = colnames(Xv),
  repo   = repo_de(item),
  p      = colMeans(Xv),
  r_itc  = r_itc,
  p_bajo = colMeans(Xv[q_bajo, ]),
  p_alto = colMeans(Xv[q_alto, ])
)
Ver código
ggplot(tibble(p = p), aes(p)) +
  geom_histogram(binwidth = .025, boundary = 0, fill = "#2a78d6", colour = "white") +
  labs(x = "Proporción de examinados que resuelven el reactivo", y = "Reactivos") +
  tema
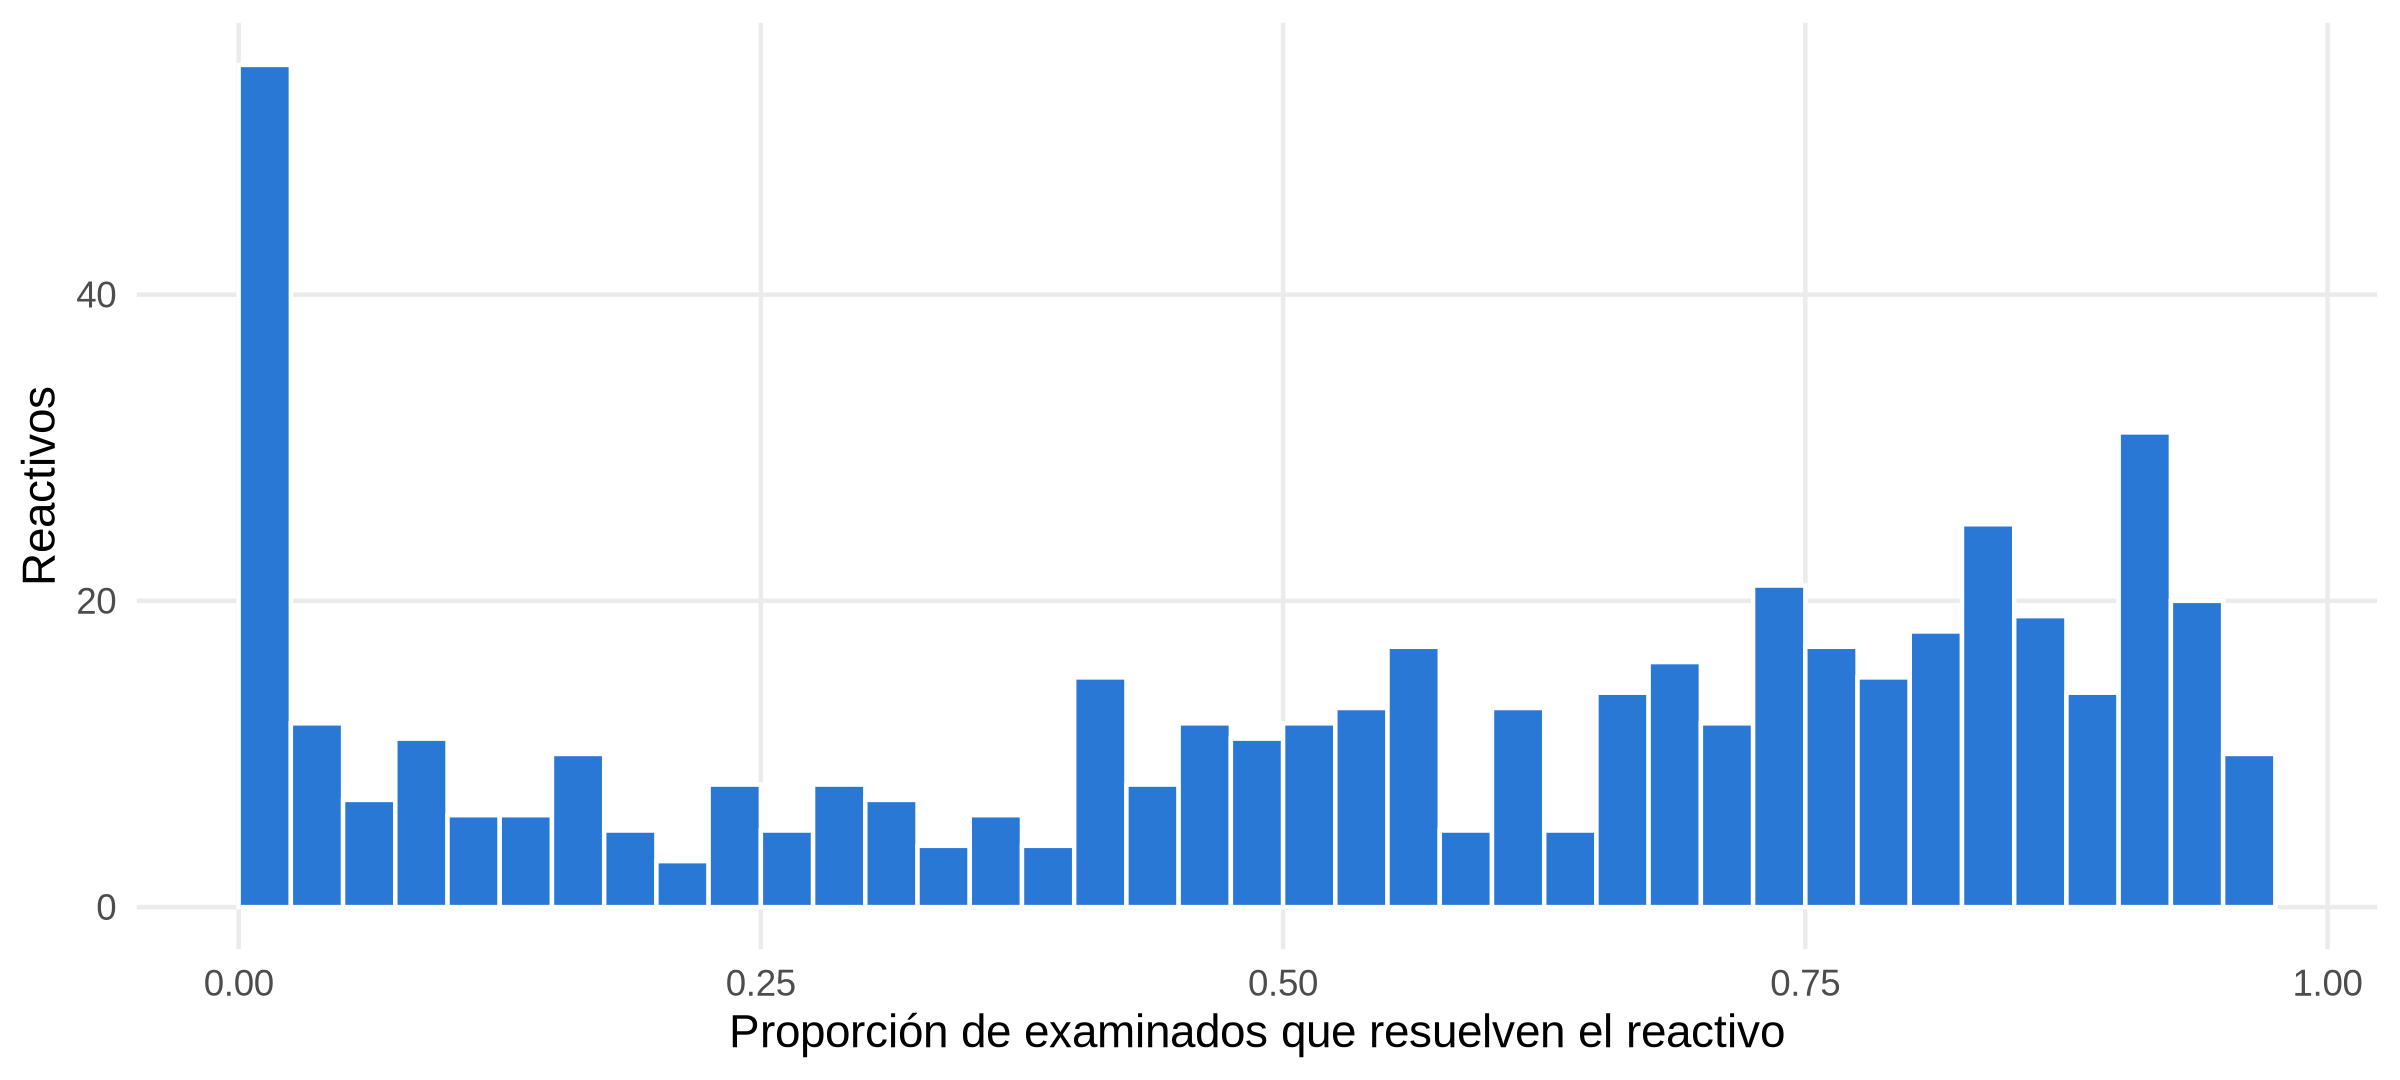
- Reactivos sin información. 26 reactivos no los resuelve ningún examinado (p = 0) y 0 los resuelven todos. Otros 27 tienen 0 < p ≤ .02, es decir, solo 1 a 3 sistemas los resuelven. Los 26 reactivos con p = 0 no contribuyen a la varianza del total ni a la estimación TRI y se excluyen de los análisis siguientes (quedan k = 474). No hay reactivos con p = 1: la prueba no tiene piso de reactivos “regalados”, aunque 61 tienen p ≥ .90.
- Consistencia interna. KR-20 = 0.994 con k = 474. Es un valor esperable, no una virtud: con cientos de reactivos y examinados que van del 0% al 79%, la varianza verdadera del total es enorme respecto a la varianza de error. Un KR-20 alto en esta muestra no dice nada sobre la precisión con la que se distinguen dos sistemas de la parte alta (eso lo responde la función de información, más abajo).
- Discriminación clásica. La mediana de la correlación reactivo-total corregida es 0.55. 59 reactivos tienen r < .20 y 7 tienen correlación negativa: los resuelven proporcionalmente más los sistemas de puntaje bajo que los de puntaje alto.
Ver código
clasico %>%
  filter(r_itc < 0) %>%
  arrange(r_itc) %>%
  mutate(across(c(p, p_bajo, p_alto), ~ sprintf("%.2f", .x)),
         r_itc = sprintf("%.2f", r_itc)) %>%
  rename(`instance_id` = item, Repositorio = repo, `r it corregida` = r_itc,
         `p (cuartil inferior)` = p_bajo, `p (cuartil superior)` = p_alto) %>%
  apa("Tabla 3. Reactivos con correlación reactivo-total corregida negativa")
| instance_id |
Repositorio |
p |
r it corregida |
p (cuartil inferior) |
p (cuartil superior) |
| sympy__sympy-18763 |
sympy |
0.32 |
-0.25 |
0.50 |
0.11 |
| astropy__astropy-7606 |
astropy |
0.05 |
-0.18 |
0.14 |
0.02 |
| django__django-11790 |
django |
0.21 |
-0.06 |
0.25 |
0.20 |
| sphinx-doc__sphinx-10614 |
sphinx-doc |
0.01 |
-0.06 |
0.02 |
0.00 |
| matplotlib__matplotlib-23476 |
matplotlib |
0.01 |
-0.04 |
0.00 |
0.00 |
| matplotlib__matplotlib-23299 |
matplotlib |
0.04 |
-0.03 |
0.07 |
0.00 |
| django__django-13794 |
django |
0.04 |
-0.03 |
0.05 |
0.05 |
Un reactivo así merece revisión de contenido antes que interpretación sustantiva. En un benchmark construido con pruebas automáticas, las explicaciones más probables no son psicológicas sino de proceso: pruebas que aceptan una solución incompleta o “de atajo” que los sistemas simples encuentran y los sofisticados no (porque hacen un cambio más amplio que rompe otra prueba), pruebas frágiles al entorno de ejecución, o especificaciones del issue que no determinan la solución que las pruebas esperan. Los datos de esta matriz no permiten distinguir entre esas hipótesis; los registros de ejecución de cada envío sí.
Dimensionalidad
Ver código
## Matriz tetracórica (psych suaviza la matriz si no es definida positiva:
## con N = 173 y k = 474 el resultado es necesariamente de rango deficiente)
invisible(capture.output(
  tc <- suppressWarnings(suppressMessages(psych::tetrachoric(Xv, smooth = TRUE)))
))
ev_tet <- eigen(tc$rho, only.values = TRUE)$values

## Matriz phi + análisis paralelo por permutación (preserva las p de cada reactivo)
ev_phi <- eigen(cor(Xv), only.values = TRUE)$values
set.seed(20261025)
ev_perm <- replicate(50, eigen(cor(apply(Xv, 2, sample)), only.values = TRUE)$values[1:10])
umbral_pa <- apply(ev_perm, 1, quantile, .95)
n_fact_pa <- sum(cumprod(ev_phi[1:10] > umbral_pa))

## ¿Qué es el segundo componente? Puntajes de componente vs. puntaje total
pc <- scale(Xv) %*% eigen(cor(Xv))$vectors[, 1:2]
r2_lin  <- summary(lm(pc[, 2] ~ tot_v))$r.squared
r2_quad <- summary(lm(pc[, 2] ~ poly(tot_v, 2)))$r.squared

## Sensibilidad: sin las líneas base RAG
Xs <- Xv[envios$familia != "Línea base RAG (2023-2024)", ]
Xs <- Xs[, colMeans(Xs) > 0 & colMeans(Xs) < 1]
ev_s <- eigen(cor(Xs), only.values = TRUE)$values
Ver código
tibble(
  componente = rep(1:10, 3),
  autovalor  = c(ev_tet[1:10], ev_phi[1:10], umbral_pa),
  matriz     = rep(c("Tetracórica", "Phi", "Permutaciones (P95)"), each = 10)
) %>%
  ggplot(aes(componente, autovalor, colour = matriz)) +
  geom_line(linewidth = .7) +
  geom_point(size = 2.2) +
  scale_colour_manual(values = c("Tetracórica" = "#2a78d6", "Phi" = "#1baf7a",
                                 "Permutaciones (P95)" = "grey55"), name = NULL) +
  scale_x_continuous(breaks = 1:10) +
  labs(x = "Componente", y = "Autovalor") +
  tema
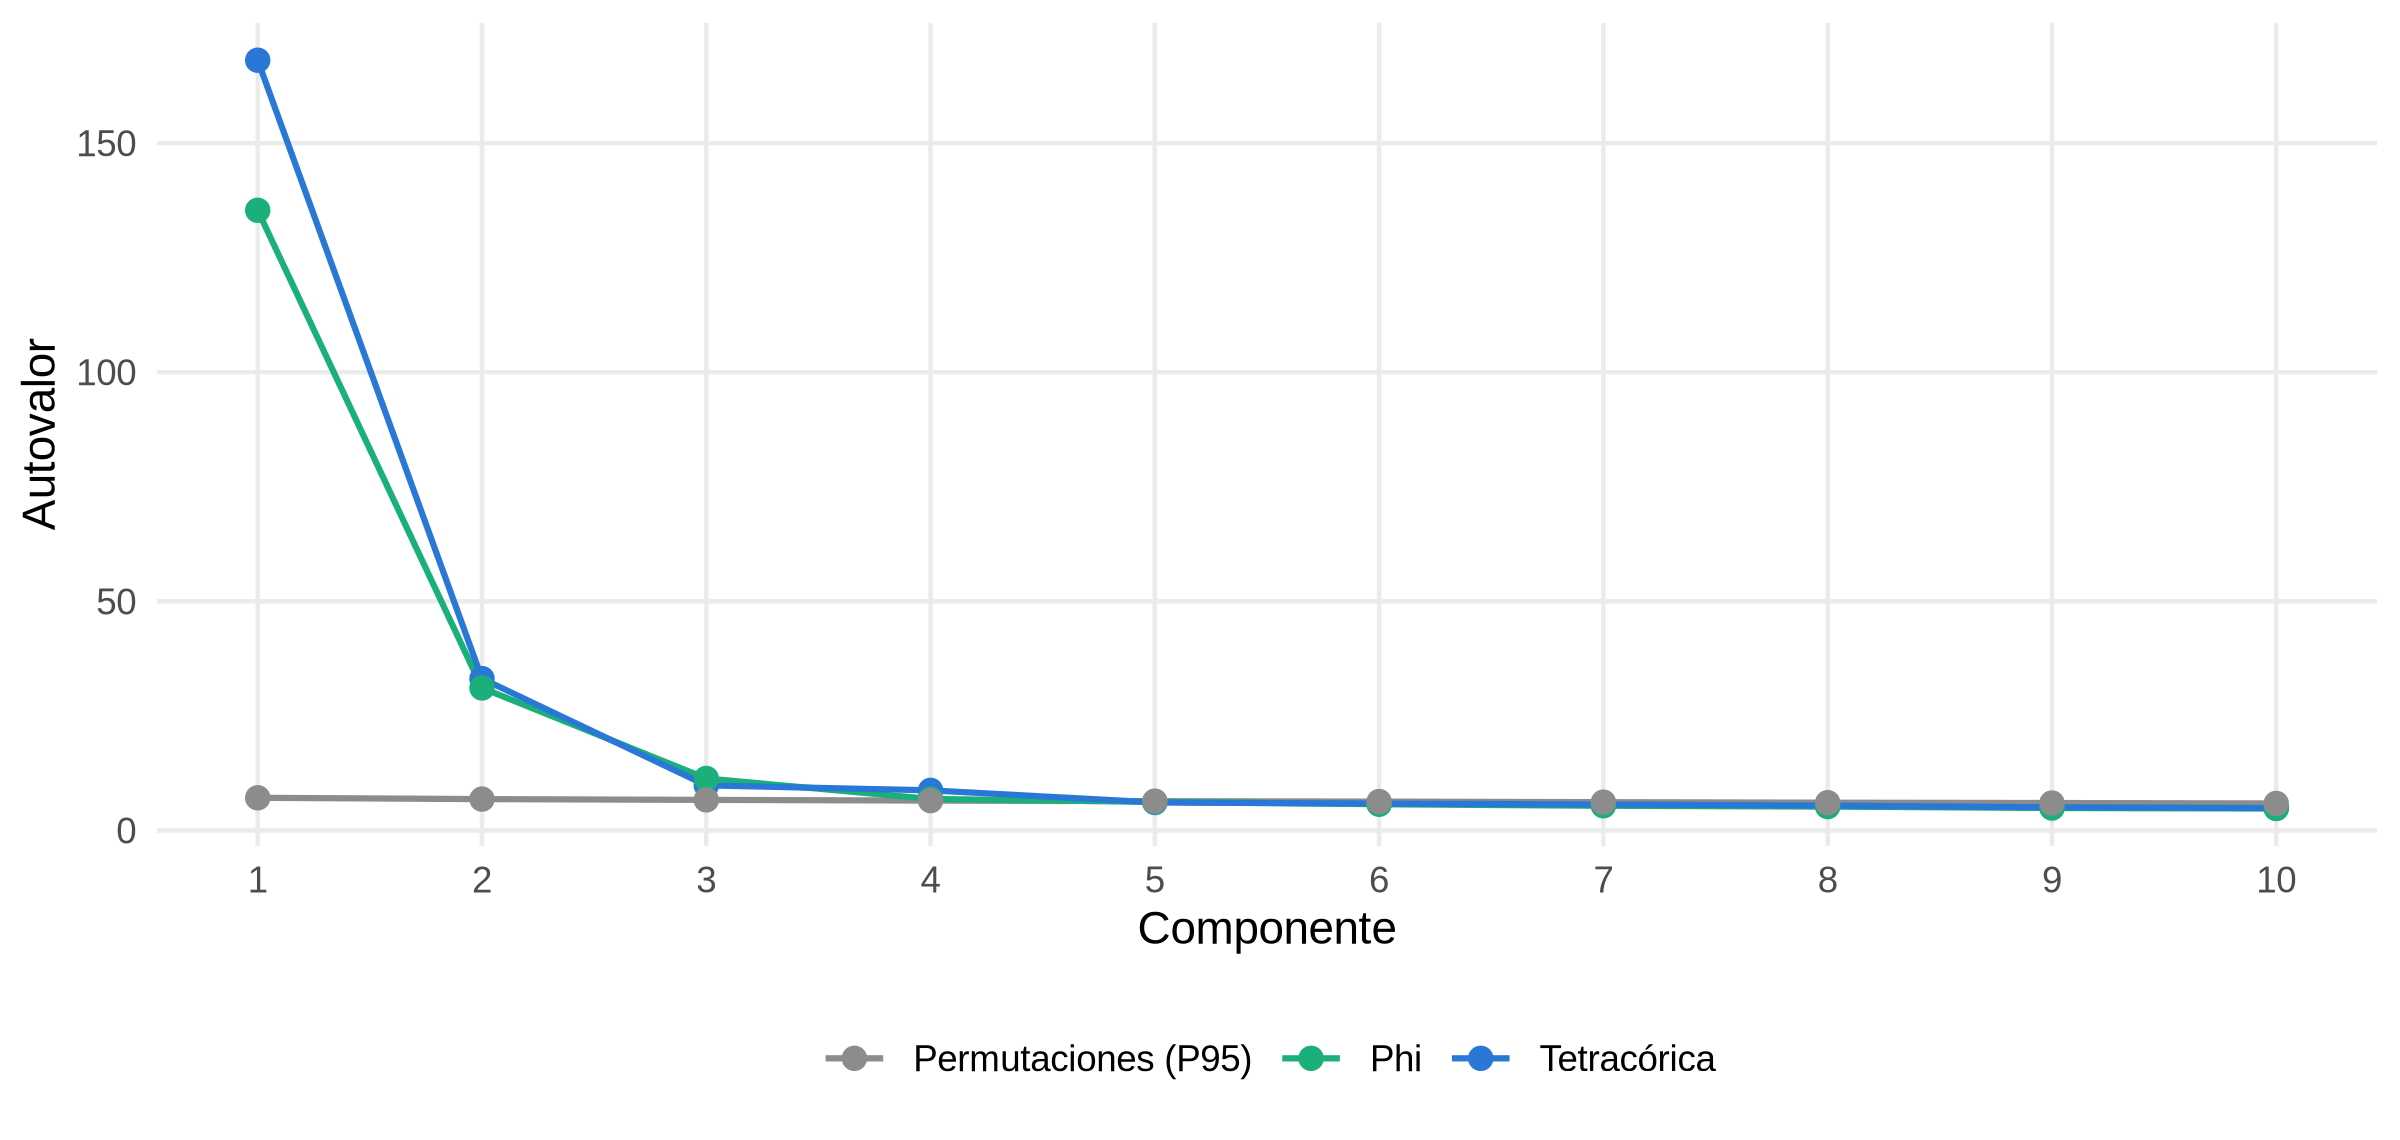
El primer autovalor de la matriz tetracórica es 168.1 (35.5% de la traza) y la razón entre el primero y el segundo es 5.07; en la matriz phi, la razón es 4.35. El análisis paralelo por permutación retiene 4 componentes, aunque a partir del tercero los autovalores son un orden de magnitud menores que el primero y se acercan al umbral (observado vs. percentil 95: 11.4 vs. 6.7; 6.9 vs. 6.5). Con N = 173 examinados y 474 reactivos, la matriz tetracórica no es definida positiva y tuvo que suavizarse; sus autovalores deben leerse como descriptivos, no como base de un AFE formal.
El segundo componente, sin embargo, tiene una lectura clara: sus puntajes casi no se relacionan linealmente con el total (R² = 0.004) pero una función cuadrática del total explica el 88% de su varianza. Es el patrón de “herradura” que aparece cuando un conjunto de reactivos tipo Guttman, fuertemente unidimensional y con dificultades muy dispersas, se factoriza linealmente: el segundo componente separa a los extremos (las líneas base RAG casi en cero) de los sistemas de puntaje medio, y es un artefacto de no linealidad más que un segundo atributo. Al quitar las 6 líneas base RAG, la razón entre los dos primeros autovalores phi pasa a 5.13.
La conclusión prudente es que un modelo unidimensional es una aproximación defendible para estos datos. Pero la unidimensionalidad empírica tiene aquí un alcance limitado: con examinados tan heterogéneos, cualquier atributo general (“capacidad del sistema”) domina la covarianza y puede ocultar dimensiones secundarias (p. ej., por repositorio o por tipo de cambio) que solo serían visibles con muchos más sistemas de capacidad parecida.
Teoría de Respuesta al Ítem
Rasch/1PL frente a 2PL
Ver código
## Rasch (pendiente común = 1, varianza latente libre)
m_rasch <- mirt(Xv, 1, itemtype = "Rasch", verbose = FALSE)

## 2PL por máxima verosimilitud marginal
m_2pl <- mirt(Xv, 1, itemtype = "2PL", verbose = FALSE,
              technical = list(NCYCLES = 2000))

## 2PL con distribución previa lognormal para las pendientes (estimación MAP)
mod_prior <- mirt.model(paste0("F = 1-", k, "\n",
                               "PRIOR = (1-", k, ", a1, lnorm, 0.5, 0.5)"))
m_2pl_p <- mirt(Xv, mod_prior, itemtype = "2PL", verbose = FALSE,
                technical = list(NCYCLES = 2000))

conv <- c(rasch = extract.mirt(m_rasch, "converged"),
          ml2pl = extract.mirt(m_2pl, "converged"),
          map2pl = extract.mirt(m_2pl_p, "converged"))

comp <- anova(m_rasch, m_2pl)
var_lat <- coef(m_rasch, simplify = TRUE)$cov[1, 1]

par_r  <- coef(m_rasch, IRTpars = TRUE, simplify = TRUE)$items
par_2  <- coef(m_2pl,   IRTpars = TRUE, simplify = TRUE)$items
par_2p <- coef(m_2pl_p, IRTpars = TRUE, simplify = TRUE)$items
Ver código
tibble(
  Modelo = c("Rasch / 1PL", "2PL (ML)"),
  Parámetros = c(extract.mirt(m_rasch, "nest"), extract.mirt(m_2pl, "nest")),
  `log L` = round(c(extract.mirt(m_rasch, "logLik"), extract.mirt(m_2pl, "logLik")), 1),
  AIC = round(comp$AIC, 1),
  BIC = round(comp$BIC, 1),
  `¿Convergió?` = ifelse(conv[1:2], "Sí", "No")
) %>%
  apa("Tabla 4. Comparación de modelos unidimensionales")
| Modelo |
Parámetros |
log L |
AIC |
BIC |
¿Convergió? |
| Rasch / 1PL |
475 |
-27176.5 |
55303.0 |
56800.8 |
Sí |
| 2PL (ML) |
948 |
-25395.9 |
52687.9 |
55677.2 |
No |
Los dos criterios de información favorecen al 2PL (ΔAIC = 2615.1, ΔBIC = 1123.6) y la razón de verosimilitudes es χ²(473) = 3561.1, p < .001. Hay que leer esta comparación con cautela:
- El 2PL por máxima verosimilitud no convergió en 2000 ciclos EM y produjo pendientes de hasta 13.1 (34 reactivos con a > 4) y 7 pendientes negativas. Con 173 examinados para 948 parámetros de reactivo, varios reactivos están casi perfectamente separados por θ y su pendiente no está identificada en la práctica. Si el algoritmo no ha llegado al máximo, el log L del 2PL es una cota inferior, así que la ventaja del 2PL no se revierte; lo que no es confiable es cada parámetro individual.
- La razón de verosimilitudes y el BIC dependen de asintóticas en N; aquí N es menor que el número de reactivos. Lo sustantivo es que la diferencia es grande y en la dirección esperada: los reactivos no discriminan igual.
- Como alternativa estable estimé un 2PL con previa lognormal(0.5, 0.5) sobre las pendientes, que convergió en 52 ciclos. Sus pendientes tienen mediana 1.49 (rango 0.19 a 3.21) y 16 reactivos tienen a < 0.5. La previa encoge las pendientes extremas, así que estas cifras describen la dispersión con sesgo hacia la media y no deben tomarse como estimaciones finales.
Las dificultades de Rasch y del 2PL con previa correlacionan r = 0.96 (Spearman ρ = 0.99), y las estimaciones EAP de θ de ambos modelos correlacionan casi perfectamente con el puntaje total. Para ordenar sistemas, la elección del modelo casi no importa; para diagnosticar reactivos, sí. En lo que sigue uso el Rasch para la escala y la información (es el modelo cuya estadística suficiente es el puntaje que publica el leaderboard) y el 2PL con previa solo como diagnóstico de discriminación.
Ver código
th <- fscores(m_rasch, method = "EAP", full.scores.SE = TRUE)
envios <- envios %>% mutate(theta = th[, "F1"], se = th[, "SE_F1"])
th_2p <- fscores(m_2pl_p, method = "EAP")[, 1]

r_th_total <- cor(envios$theta, envios$total, method = "spearman")
r_th_2p    <- cor(envios$theta, th_2p)
(La correlación de Spearman entre θ del Rasch y el puntaje total es 1.0000; entre θ del Rasch y θ del 2PL con previa, r = 0.997.) La varianza latente estimada en el Rasch es 3.66 (DE = 1.91 logits), reflejo de la heterogeneidad de los examinados.
Ver código
grid_th <- seq(-7, 7, by = .01)
info <- testinfo(m_rasch, matrix(grid_th))
th_max_info <- grid_th[which.max(info)]

th_top  <- max(envios$theta)
info_top <- testinfo(m_rasch, matrix(th_top))
se_top   <- 1 / sqrt(info_top)

b_r <- par_r[, "b"]
n_b_sobre_top <- sum(b_r > th_top)

## Sistemas de la frontera: los 20 de mayor θ
## En Rasch el θ es función del total, así que se ordena por el total (entero)
## para que los empates no se decidan por ruido de punto flotante. El empate
## se rompe por el ID del envío, que empieza con su fecha: gana el más antiguo.
top20 <- envios %>% arrange(desc(total), envio) %>% slice_head(n = 20)
X20 <- X[top20$envio, ]
p20 <- colMeans(X20)
Ver código
ggplot() +
  geom_line(aes(grid_th, info), colour = "#2a78d6", linewidth = .8) +
  geom_rug(data = envios, aes(theta, colour = familia), sides = "b",
           length = unit(.05, "npc"), alpha = .8) +
  geom_vline(xintercept = th_top, linetype = "dashed", colour = "grey40") +
  scale_colour_manual(values = col_familia, name = NULL) +
  labs(x = "θ (logits, escala Rasch)", y = "Información del test") +
  tema
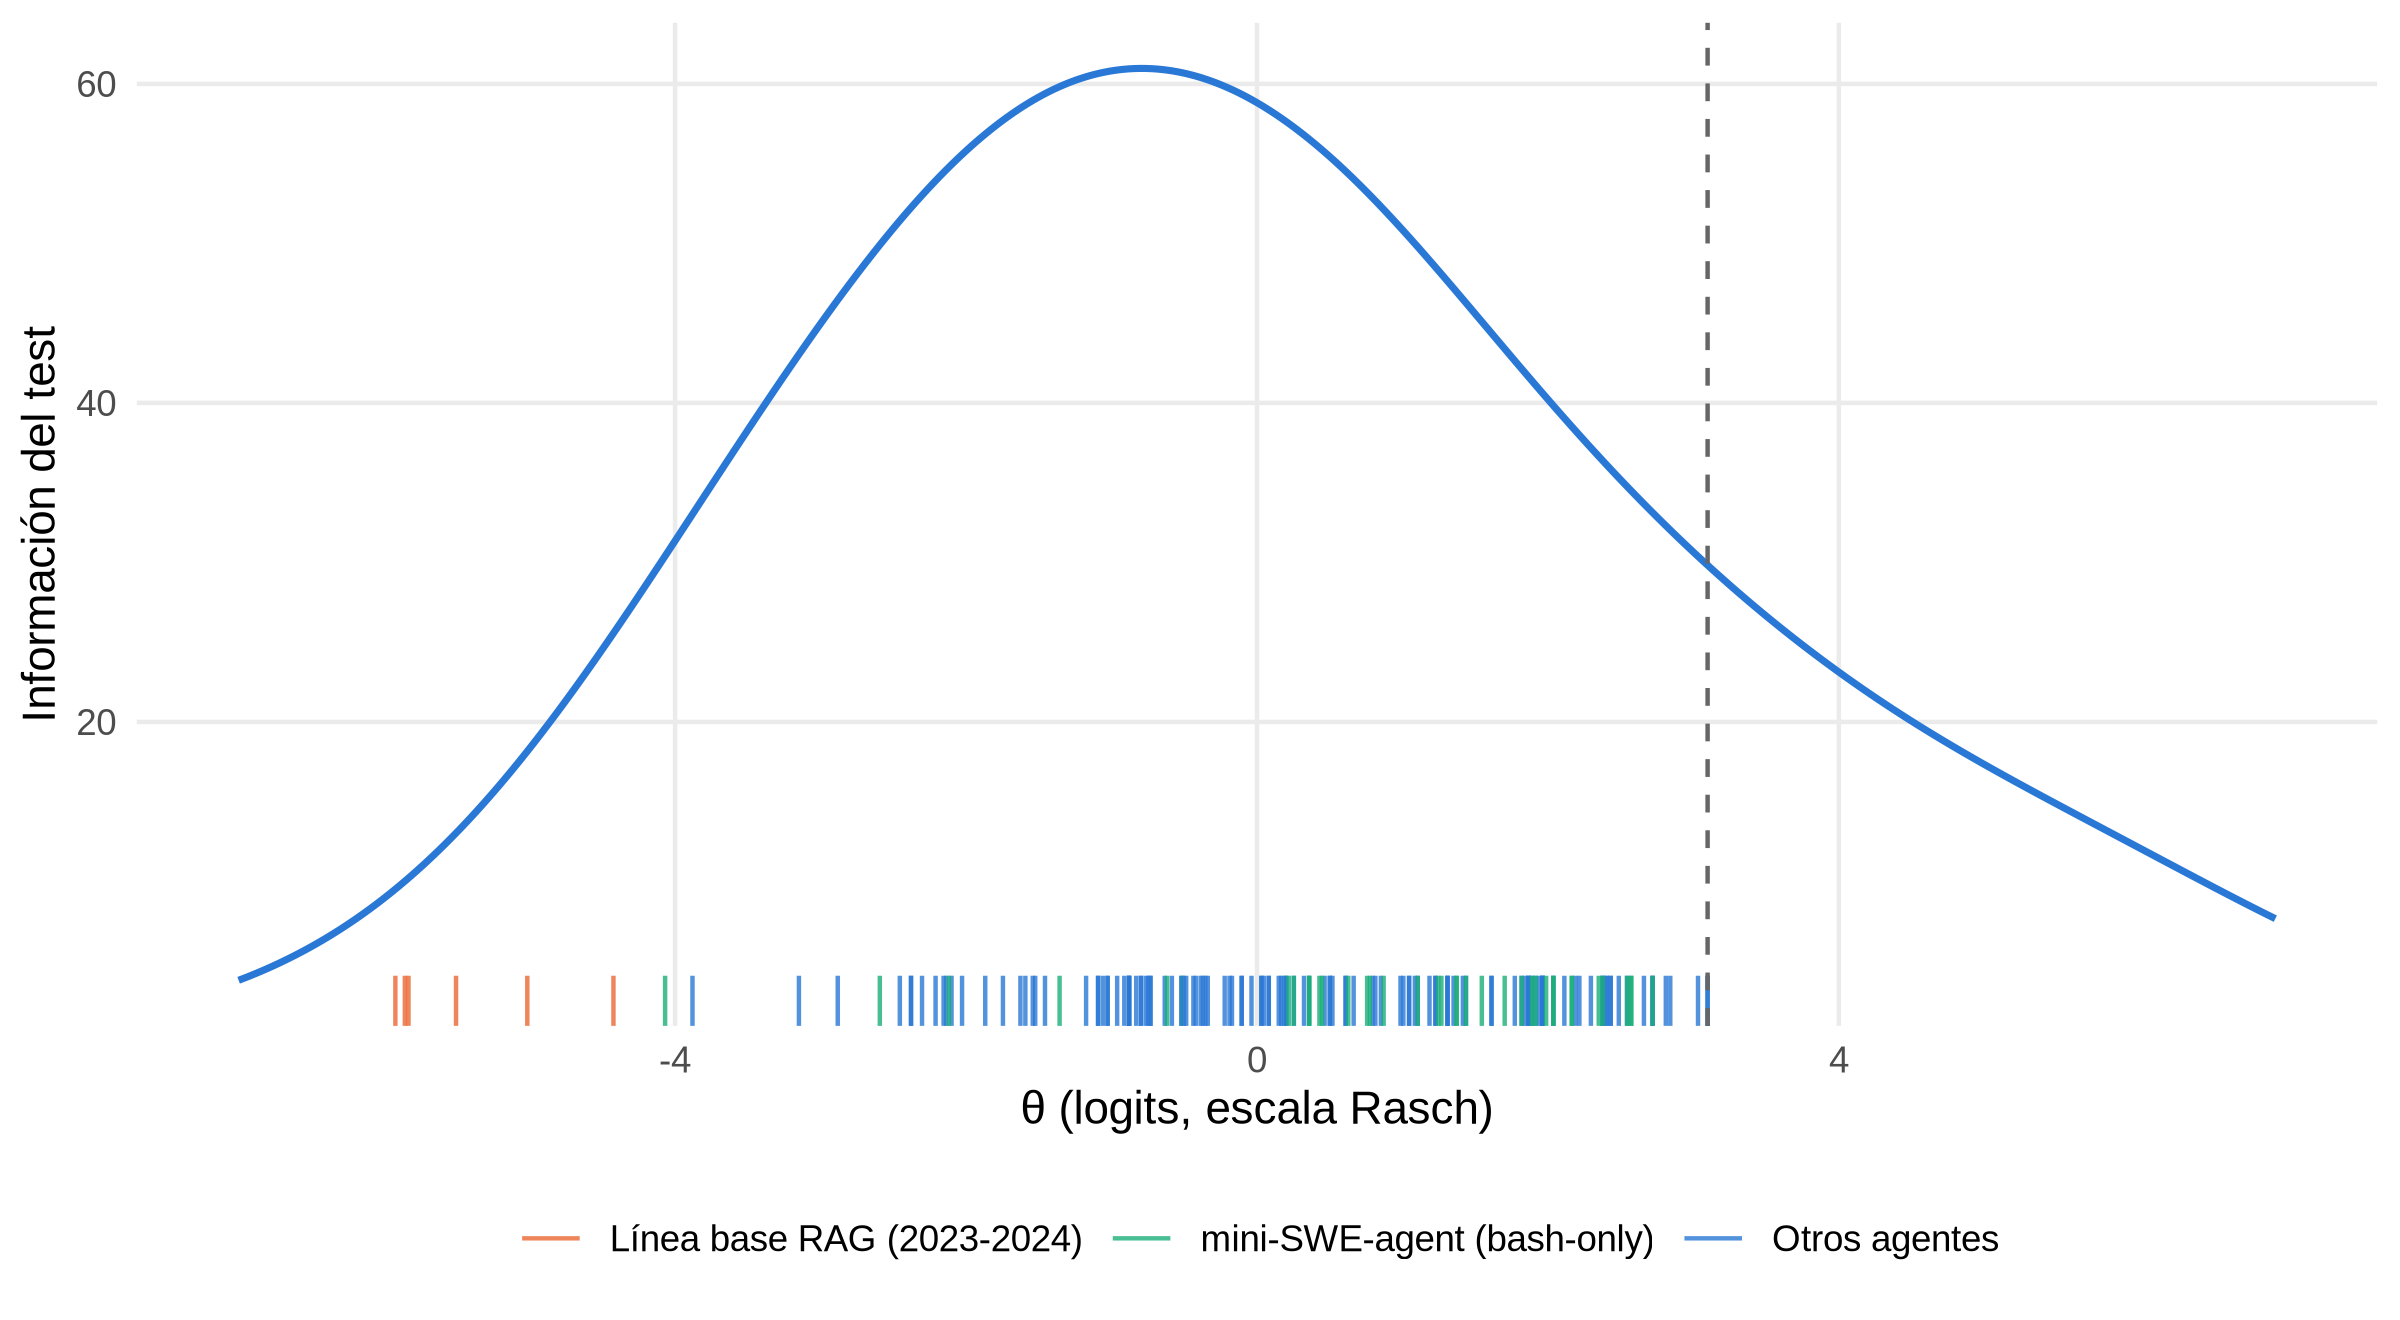
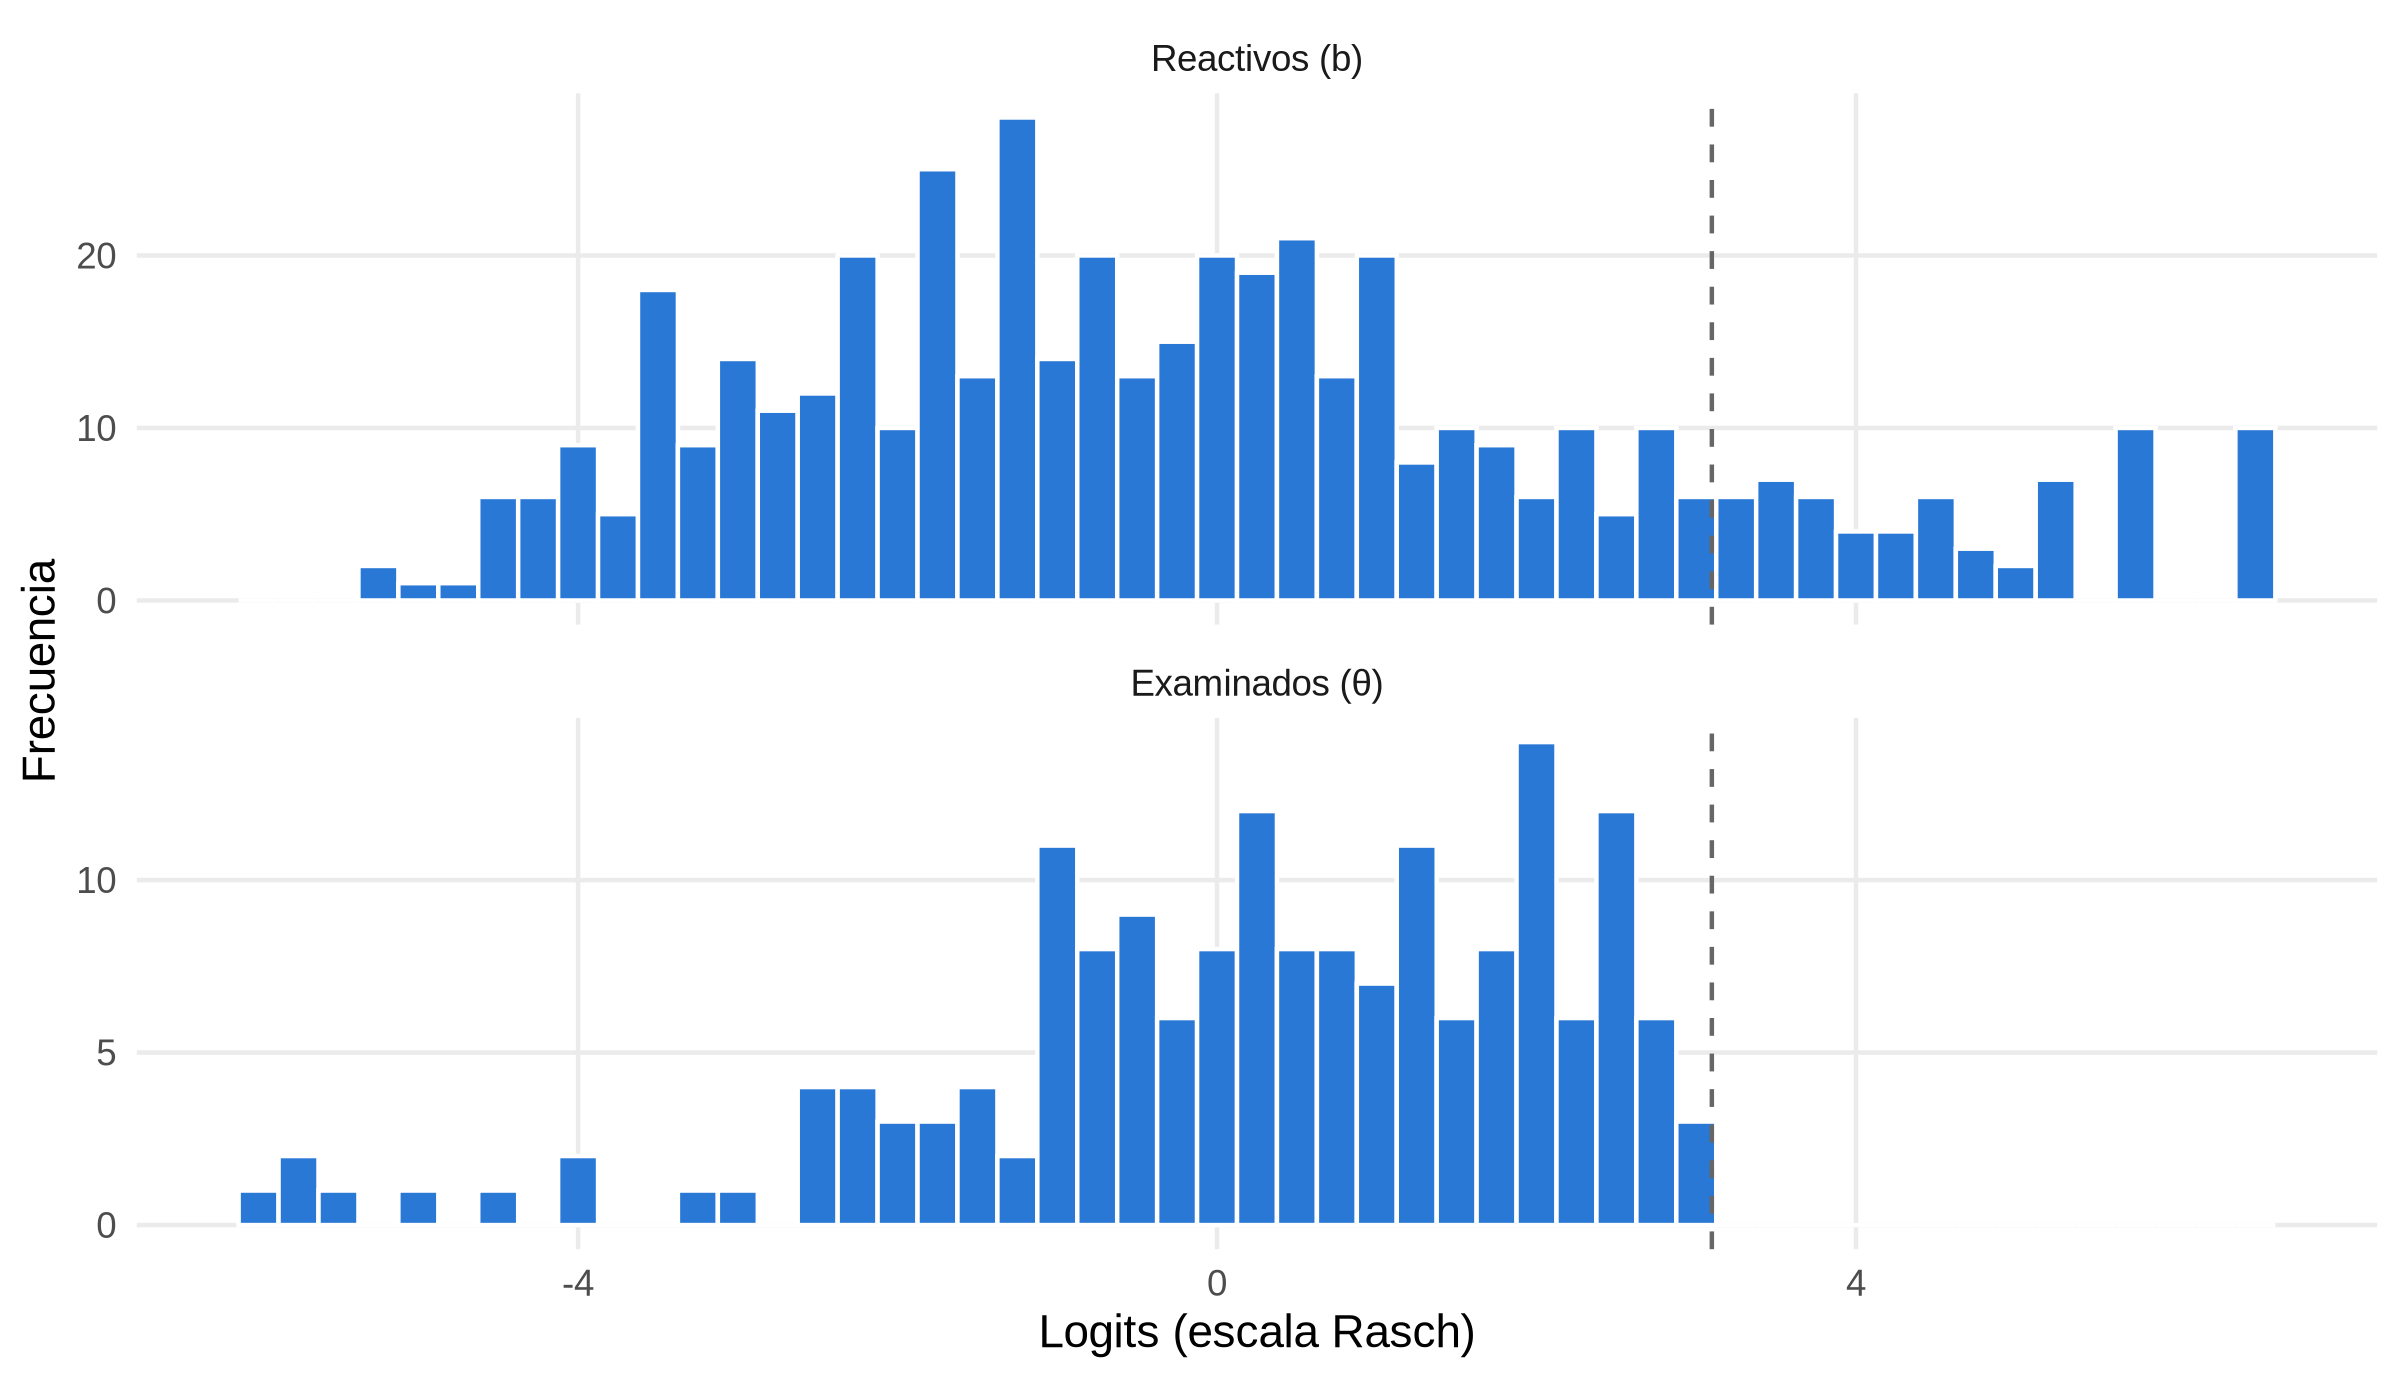
La información del test es máxima en θ = -0.79 (I = 61), por debajo de la mediana de los examinados (θ mediana = 0.46). En el sistema con θ más alto (θ = 3.10), la información cae a 29.8 (49% del máximo), con un error estándar condicional de 0.18 logits. Todavía no hay techo en sentido estricto: 65 reactivos tienen dificultad Rasch mayor que el θ del mejor sistema, a los que se suman los 26 reactivos que nadie ha resuelto.
La saturación aparece cuando se mira la frontera de cerca. Entre los 20 sistemas con θ más alto (de 372 a 396 reactivos resueltos), 254 reactivos los resuelven todos y 36 no los resuelve ninguno; solo 210 reactivos (42% de la prueba) tienen variación dentro de ese grupo. Las diferencias de unos cuantos puntos porcentuales en la parte alta del leaderboard descansan, por tanto, en un subconjunto de reactivos bastante más pequeño que 500, y con SE ≈ 0.18 logits en esa región las diferencias de θ menores que unos 0.5 logits (≈ 2·√2·SE) no son distinguibles con una confianza razonable.
Ver código
bind_rows(
  tibble(valor = b_r, tipo = "Reactivos (b)"),
  tibble(valor = envios$theta, tipo = "Examinados (θ)")
) %>%
  mutate(tipo = factor(tipo, c("Reactivos (b)", "Examinados (θ)"))) %>%
  ggplot(aes(valor)) +
  geom_histogram(binwidth = .25, fill = "#2a78d6", colour = "white") +
  geom_vline(xintercept = th_top, linetype = "dashed", colour = "grey40") +
  facet_wrap(~tipo, ncol = 1, scales = "free_y") +
  labs(x = "Logits (escala Rasch)", y = "Frecuencia") +
  tema
Ajuste de reactivos y de examinados
Ver código
ajuste_items <- itemfit(m_rasch, fit_stats = "infit") %>%
  as_tibble() %>%
  select(item, outfit, infit)

ajuste_pers <- personfit(m_rasch) %>%
  as_tibble() %>%
  select(outfit, infit, Zh) %>%
  mutate(envio = rownames(Xv)) %>%
  left_join(envios %>% select(envio, total, n_sin_parche, familia), by = "envio")

diag_items <- clasico %>%
  left_join(ajuste_items, by = "item") %>%
  mutate(b_rasch = b_r[item], a_2pl = par_2p[item, "a"],
         n_banderas = (r_itc < .10) + (a_2pl < .50) + (infit > 1.30))
Con los criterios habituales (infit > 1.3, outfit > 2), 36 reactivos muestran ajuste pobre por infit y 63 por outfit. Los valores de outfit son sensibles a respuestas inesperadas en los extremos: el patrón típico es un reactivo difícil resuelto por un sistema débil. La Tabla 5 cruza tres banderas (r reactivo-total corregida < .10, pendiente 2PL con previa < 0.5 e infit > 1.3) y muestra los reactivos que acumulan al menos dos.
Ver código
diag_items %>%
  filter(n_banderas >= 2) %>%
  arrange(desc(n_banderas), r_itc) %>%
  transmute(instance_id = item, Repositorio = repo,
            p = sprintf("%.2f", p), `r it` = sprintf("%.2f", r_itc),
            `b Rasch` = sprintf("%.2f", b_rasch), `a 2PL` = sprintf("%.2f", a_2pl),
            Infit = sprintf("%.2f", infit), Outfit = sprintf("%.2f", outfit),
            Banderas = n_banderas) %>%
  apa("Tabla 5. Reactivos con dos o más banderas de funcionamiento anómalo")
| instance_id |
Repositorio |
p |
r it |
b Rasch |
a 2PL |
Infit |
Outfit |
Banderas |
| sympy__sympy-18763 |
sympy |
0.32 |
-0.25 |
1.54 |
0.19 |
2.38 |
5.98 |
3 |
| django__django-11790 |
django |
0.21 |
-0.06 |
2.31 |
0.31 |
1.66 |
5.95 |
3 |
| pylint-dev__pylint-7277 |
pylint-dev |
0.60 |
0.00 |
-0.21 |
0.28 |
2.22 |
3.96 |
3 |
| psf__requests-1724 |
psf |
0.57 |
0.05 |
-0.02 |
0.31 |
2.09 |
4.47 |
3 |
| django__django-12325 |
django |
0.11 |
0.06 |
3.28 |
0.47 |
1.33 |
4.37 |
3 |
| astropy__astropy-7606 |
astropy |
0.05 |
-0.18 |
4.32 |
0.38 |
1.20 |
9.75 |
2 |
| django__django-14140 |
django |
0.27 |
0.11 |
1.93 |
0.42 |
1.62 |
2.94 |
2 |
| pytest-dev__pytest-7205 |
pytest-dev |
0.62 |
0.12 |
-0.36 |
0.36 |
2.00 |
3.01 |
2 |
| pydata__xarray-6599 |
pydata |
0.31 |
0.12 |
1.61 |
0.40 |
1.70 |
2.71 |
2 |
| psf__requests-2317 |
psf |
0.58 |
0.12 |
-0.06 |
0.36 |
1.98 |
2.96 |
2 |
| sympy__sympy-23950 |
sympy |
0.57 |
0.13 |
-0.02 |
0.35 |
2.01 |
2.71 |
2 |
| psf__requests-1766 |
psf |
0.66 |
0.14 |
-0.65 |
0.39 |
1.97 |
3.03 |
2 |
| sphinx-doc__sphinx-8595 |
sphinx-doc |
0.76 |
0.23 |
-1.37 |
0.47 |
1.60 |
4.93 |
2 |
| django__django-12193 |
django |
0.53 |
0.23 |
0.24 |
0.50 |
1.75 |
2.02 |
2 |
| psf__requests-1921 |
psf |
0.50 |
0.24 |
0.45 |
0.49 |
1.69 |
2.12 |
2 |
| django__django-15022 |
django |
0.52 |
0.27 |
0.31 |
0.49 |
1.70 |
2.03 |
2 |
16 reactivos acumulan dos o más banderas. Son los candidatos naturales para una auditoría de las pruebas de aceptación: si un reactivo no ordena a los sistemas igual que el resto, la explicación más económica es un defecto del reactivo (pruebas demasiado permisivas o demasiado específicas respecto al issue), no un “factor” sustantivo.
Ver código
## Registros públicos de evaluación de cada envío (bucket swe-bench-submissions),
## resumidos por envío: núcleos del contenedor (si pylint omitió sus pruebas
## "needs_two_cores") y respuestas 5xx de httpbin.org en las pruebas de requests.
entorno <- read_csv("entorno_swebench_verified.csv", show_col_types = FALSE)
items_entorno <- c("pylint-dev__pylint-7277", "pylint-dev__pylint-6528",
                   "psf__requests-1724", "psf__requests-1766",
                   "psf__requests-1921", "psf__requests-2317")
band_entorno <- diag_items %>% filter(n_banderas >= 2, item %in% items_entorno)
p7277 <- entorno %>%
  filter(pylint7277_f2p_ok == 1, pylint7277_nucleos %in% c("1", "2+")) %>%
  group_by(nucleos = pylint7277_nucleos) %>%
  summarise(n = n(), resueltos = sum(pylint7277_resuelto), .groups = "drop")
p7277_2 <- p7277 %>% filter(nucleos == "2+")
p7277_1 <- p7277 %>% filter(nucleos == "1")
n5xx      <- sum(entorno$httpbin_5xx == 1, na.rm = TRUE)
n5xx_dato <- sum(!is.na(entorno$httpbin_5xx))
mini_cpu  <- entorno %>% filter(mini_swe_agent == 1, !is.na(menos_2_cpu))
Hay algo más sobre esas banderas que no se ve en la matriz. Revisé los registros públicos de evaluación que el repositorio guarda para cada envío, el report.json y la salida de las pruebas de cada reactivo, y en 5 de esos 16 reactivos la causa del mal funcionamiento está en la máquina que corrió las pruebas. Los de pylint incluyen pruebas que pylint omite cuando el contenedor tiene menos de dos núcleos, y el arnés cuenta la omisión como un fallo, de modo que un parche correcto puede quedar como no resuelto: en pylint-7277, entre los envíos cuyo parche pasa la prueba que el issue pide, lo resuelven 94 de 95 cuando el contenedor tenía dos o más núcleos y 0 de 50 cuando tenía menos. Los de requests dependen de un servicio externo, httpbin.org, y fallan cuando ese servicio responde con un error del servidor, lo que ocurrió en 76 de los 157 envíos con registros legibles. Ninguna de las dos cosas tiene que ver con resolver el issue y, sin embargo, las dos entran en el porcentaje. Son 6 reactivos, es decir, hasta 1.2 puntos porcentuales por envío, que es el orden de las diferencias que separan a los primeros lugares.
Esas condiciones, además, no se repartieron parejo: casi todas las corridas de mini-SWE-agent, el andamiaje mínimo del leaderboard bash-only, se evaluaron con menos de dos núcleos (36 de 37), así que comparar ese andamiaje con los demás también es comparar máquinas. A mi parecer, que el análisis de ajuste marcara estos reactivos antes de saber todo esto es una buena razón para mirar un benchmark como un test.
El ajuste de examinados también es informativo. Los cinco envíos con Zh más negativo (peor ajuste) son:
Ver código
ajuste_pers %>%
  arrange(Zh) %>%
  slice_head(n = 5) %>%
  transmute(Envío = envio, Familia = familia, Resueltos = total,
            `Sin parche` = n_sin_parche, Zh = sprintf("%.2f", Zh),
            Infit = sprintf("%.2f", infit), Outfit = sprintf("%.2f", outfit)) %>%
  apa("Tabla 6. Examinados con peor ajuste al modelo de Rasch (Zh)")
| Envío |
Familia |
Resueltos |
Sin parche |
Zh |
Infit |
Outfit |
| 20260901_mini-v2.4.2_gemini-3-5-flash |
mini-SWE-agent (bash-only) |
359 |
59 |
-9.87 |
1.81 |
3.95 |
| 20250627_agentless_MCTS-Refine-7B |
Otros agentes |
116 |
39 |
-8.23 |
1.40 |
5.76 |
| 20250110_learn_by_interact_claude3.5 |
Otros agentes |
301 |
0 |
-7.20 |
1.46 |
2.78 |
| 20251209_mini-v1.17.2_devstral-2512 |
mini-SWE-agent (bash-only) |
269 |
0 |
-6.71 |
1.38 |
2.86 |
| 20250807_mini-v1.7.0_kimi-k2-instruct |
mini-SWE-agent (bash-only) |
219 |
0 |
-6.41 |
1.39 |
1.68 |
Ver código
peor <- ajuste_pers %>% slice_min(Zh, n = 1)
r_zh_sinparche <- cor(ajuste_pers$Zh, ajuste_pers$n_sin_parche,
                      method = "spearman", use = "complete.obs")
El examinado de peor ajuste (20260901_mini-v2.4.2_gemini-3-5-flash, Zh = -9.9) tiene 59 reactivos sin parche registrado, que la regla de calificación cuenta como errores. Un sistema que falla por infraestructura (tiempo agotado, error de API, contenedor que no arranca) produce ceros que no dependen de la dificultad del reactivo, y eso es exactamente lo que el modelo detecta como desajuste: un sistema que resuelve 359 reactivos “falla” otros fáciles. No es, sin embargo, la única fuente de desajuste: 3 de los cinco envíos de la Tabla 6 no tienen reactivos sin parche, y en todo el conjunto la correlación de Spearman entre Zh y el número de reactivos sin parche es apenas -0.10. Los perfiles idiosincrásicos (sistemas que resuelven reactivos difíciles y fallan fáciles por razones propias del andamiaje o del modelo) son otra fuente. Para la interpretación del porcentaje publicado, el caso extremo muestra que una parte de la variación entre sistemas puede ser varianza irrelevante al constructo (construct-irrelevant variance) asociada a la ejecución, no a la capacidad de resolver el problema.
Dependencia local por repositorio
Los 500 reactivos provienen de 12 repositorios, con una distribución muy desigual. Si los reactivos de un mismo repositorio comparten demandas específicas (convenciones del código base, infraestructura de pruebas), funcionarían como testlets y violarían la independencia local. Lo examiné con el estadístico Q3 de Yen sobre los residuales del modelo de Rasch, comparando pares de reactivos del mismo repositorio con pares de repositorios distintos.
Ver código
q3 <- residuals(m_rasch, type = "Q3", verbose = FALSE)
repo_v <- repo_de(colnames(Xv))
ut <- upper.tri(q3)
mismo <- outer(repo_v, repo_v, "==")

q3_dentro <- mean(q3[ut & mismo])
q3_entre  <- mean(q3[ut & !mismo])
q3_alto   <- mean(abs(q3[ut]) > .2)

q3_repo <- sapply(split(seq_along(repo_v), repo_v), function(ix) {
  if (length(ix) < 2) return(NA_real_)
  s <- q3[ix, ix]
  mean(s[upper.tri(s)])
})

tabla_repo <- tibble(item = colnames(X), repo = repo_de(item), p = p) %>%
  group_by(repo) %>%
  summarise(n = n(), n_p0 = sum(p == 0), p_media = mean(p), .groups = "drop") %>%
  left_join(tibble(repo = repo_v, b = b_r) %>%
              group_by(repo) %>% summarise(b_media = mean(b), .groups = "drop"),
            by = "repo") %>%
  mutate(q3_medio = q3_repo[repo]) %>%
  arrange(desc(n))
Ver código
tabla_repo %>%
  transmute(Repositorio = repo, Reactivos = n, `p = 0` = n_p0,
            `p media` = sprintf("%.2f", p_media),
            `b media (Rasch)` = sprintf("%.2f", b_media),
            `Q3 medio intra-repo` = ifelse(is.na(q3_medio), "—", sprintf("%.3f", q3_medio))) %>%
  apa("Tabla 7. Reactivos, dificultad y dependencia local por repositorio")
| Repositorio |
Reactivos |
p = 0 |
p media |
b media (Rasch) |
Q3 medio intra-repo |
| django |
231 |
13 |
0.57 |
-0.45 |
0.003 |
| sympy |
75 |
3 |
0.50 |
0.33 |
0.006 |
| sphinx-doc |
44 |
2 |
0.43 |
1.09 |
0.025 |
| matplotlib |
34 |
2 |
0.48 |
0.55 |
0.038 |
| scikit-learn |
32 |
0 |
0.71 |
-1.44 |
0.015 |
| astropy |
22 |
1 |
0.42 |
1.00 |
0.017 |
| pydata |
22 |
2 |
0.57 |
-0.68 |
0.020 |
| pytest-dev |
19 |
0 |
0.59 |
-0.28 |
0.002 |
| pylint-dev |
10 |
3 |
0.26 |
1.13 |
0.079 |
| psf |
8 |
0 |
0.48 |
0.67 |
0.138 |
| mwaskom |
2 |
0 |
0.20 |
2.80 |
-0.062 |
| pallets |
1 |
0 |
0.90 |
-3.02 |
— |
El Q3 medio entre pares del mismo repositorio es 0.005 y entre pares de repositorios distintos -0.003 (el valor esperado bajo independencia local es ligeramente negativo, ≈ −1/(k − 1)). La diferencia es pequeña y solo 3.8% de los pares tiene |Q3| > .20. A nivel agregado no hay evidencia fuerte de efecto testlet por repositorio; los valores intra-repositorio más altos aparecen en repositorios con pocos reactivos, donde la media de Q3 es inestable.
Lo que sí es notable es el desbalance de contenido: django aporta 231 reactivos (46% de la prueba) y, junto con sympy (75), más de la mitad. El porcentaje global es, en buena medida, un porcentaje de éxito en esos dos códigos base. Esto no es un problema de estructura interna sino de representatividad del dominio, y se discute en la ficha de validez.
Tendencia temporal
Ver código
ggplot(envios, aes(fecha, theta)) +
  geom_smooth(data = filter(envios, familia != "Línea base RAG (2023-2024)"),
              method = "loess", formula = y ~ x, se = FALSE,
              colour = "grey45", linewidth = .7) +
  geom_point(aes(colour = familia), size = 2.2, alpha = .85) +
  geom_hline(yintercept = th_max_info, linetype = "dotted", colour = "grey40") +
  scale_colour_manual(values = col_familia, name = NULL) +
  labs(x = "Fecha del envío", y = "θ (logits)") +
  tema
Ver código
por_anio <- envios %>%
  mutate(anio = format(fecha, "%Y")) %>%
  group_by(anio) %>%
  summarise(n = n(), theta_mediana = median(theta), theta_max = max(theta),
            pct_max = 100 * max(total) / 500, .groups = "drop")
pct_sobre <- with(filter(envios, fecha >= as.Date("2025-01-01")), mean(theta > th_max_info))

por_anio %>%
  transmute(Año = anio, Envíos = n,
            `θ mediana` = sprintf("%.2f", theta_mediana),
            `θ máxima` = sprintf("%.2f", theta_max),
            `% resuelto máximo` = sprintf("%.1f", pct_max)) %>%
  apa("Tabla 8. θ de los envíos por año")
| Año |
Envíos |
θ mediana |
θ máxima |
% resuelto máximo |
| 2023 |
4 |
-5.84 |
-5.02 |
4.4 |
| 2024 |
51 |
-0.88 |
0.99 |
62.2 |
| 2025 |
106 |
1.23 |
3.10 |
79.2 |
| 2026 |
12 |
2.10 |
2.72 |
76.8 |
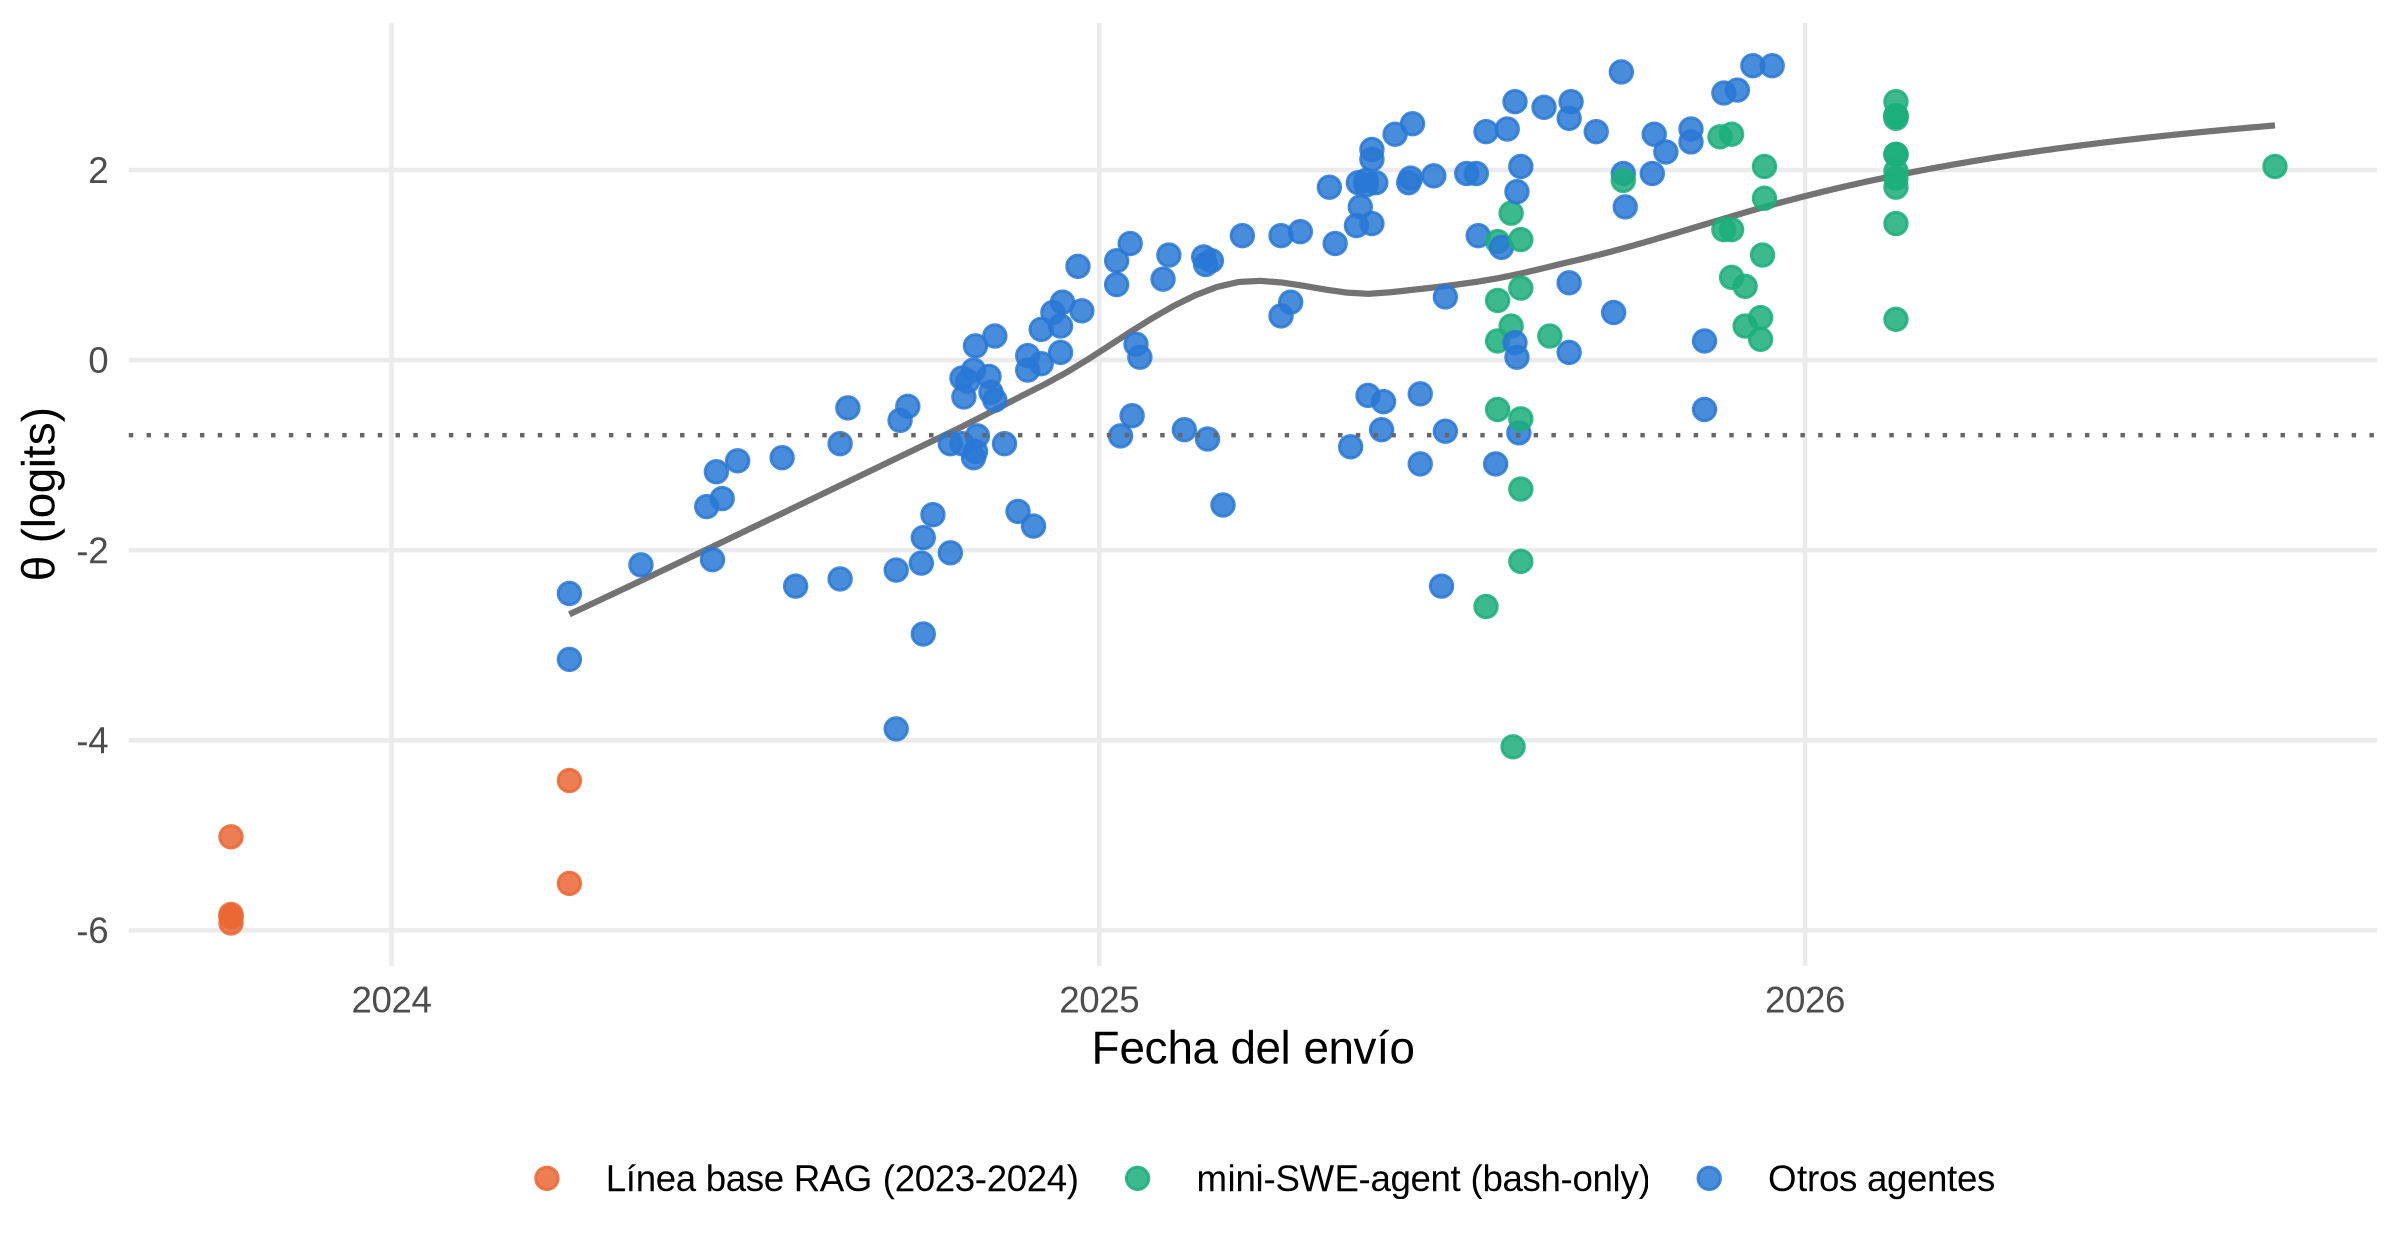
La línea punteada de la Figura 6 marca el θ donde la prueba es más informativa. De los envíos fechados desde 2025, el 91% está por encima de ese punto, y la frontera avanza hacia la región donde la información cae. El salto de 2024 a 2025 en el θ máximo es grande; en 2026 hay solo 12 envíos (desde noviembre de 2025 el repositorio solo admite en Verified envíos de equipos académicos o de investigación con publicación de métodos) y ninguno supera el máximo de 2025. Con tan pocos datos recientes no se puede separar un avance real más lento de una compresión de la escala en la región alta, donde quedan pocos reactivos con dificultad adecuada (y una parte de ellos podría no tener solución válida por defectos de las pruebas). Las corridas de mini-SWE-agent (verde) son la comparación más limpia, porque mantienen el andamiaje casi constante y cambian sobre todo el modelo.
Qué implica para la interpretación de “N% en SWE-bench Verified”
- El puntaje total es una medida razonablemente unidimensional para esta población de sistemas. El dominio del primer componente, el carácter de artefacto del segundo y la ausencia de dependencia local fuerte por repositorio respaldan que sumar los 500 reactivos tiene sentido como indicador de un atributo general. Es evidencia de estructura interna a favor de la interpretación, con la reserva de que la heterogeneidad extrema de los examinados facilita encontrar un factor dominante.
- La precisión no es uniforme, y es peor donde hoy se compite. El KR-20 es alto porque la muestra abarca del 0% al 79%. La función de información muestra que la prueba mide mejor alrededor de θ ≈ -0.8; en la frontera, la información es 49% del máximo y solo 210 reactivos varían entre los 20 mejores sistemas. Diferencias de uno o dos puntos porcentuales entre sistemas punteros no deberían reportarse como diferencias de capacidad sin un error estándar.
- Los reactivos no son intercambiables. El 2PL ajusta claramente mejor que el Rasch, y hay un grupo identificable de reactivos con discriminación nula o negativa. El porcentaje del leaderboard pondera a todos por igual; un subconjunto pequeño de reactivos probablemente defectuosos añade ruido justo donde la prueba ya tiene poca información. Al menos 5 de esos reactivos, además, dependen del entorno de evaluación.
- 26 reactivos (5.2%) no los ha resuelto ningún sistema. O son genuinamente difíciles o son irresolubles con las pruebas actuales. Mientras no se audite cuál de las dos, el techo efectivo de la escala es menor que 100%.
- Parte de la varianza puede ser de ejecución, no de capacidad. El examinado con peor ajuste combina un puntaje alto con 59 reactivos sin parche, que cuentan como errores. Aunque la asociación en todo el conjunto es débil, un “N%” mezcla capacidad de resolver con robustez operativa del andamiaje, y el leaderboard no las separa. Los registros de evaluación lo confirman para 6 reactivos cuyo resultado depende de los núcleos del contenedor o de un servicio externo.
Lo que me deja este análisis es algo incómodo, pues SWE-bench Verified funciona bastante bien para lo que fue construido, que es ordenar sistemas muy distintos entre sí, y funciona bastante mal para lo que hoy más se usa, que es decidir cuál de los sistemas de la parte alta es el mejor. Precisamente ahí, en la frontera, donde se pelean los primeros lugares, es donde la prueba tiene menos información, donde quedan menos reactivos que distingan a un sistema de otro y donde, quizá, se concentran los reactivos defectuosos. Pese a ello, considero que sería un error darle portazo al benchmark; lo que sí creo firmemente es que la cifra debería reportarse con su error estándar, y que una diferencia de dos puntos entre dos modelos no debería presentarse como una diferencia de capacidad. Aún me quedan preguntas que estos datos no alcanzan a responder, la más importante de ellas si los 26 reactivos que nadie ha resuelto son difíciles o son, sencillamente, irresolubles, y quizá es una pregunta que le corresponde contestar a quien tenga el tiempo de abrir sus pruebas una por una.
Limitaciones
- Los examinados no son una muestra de una población. Son envíos voluntarios al leaderboard, con autoselección (se publica lo que sale bien), y su distribución cambia con el tiempo. Los parámetros de los reactivos dependen de esta muestra; en particular, la varianza latente y la información en la parte baja están inflados por un puñado de líneas base RAG.
- Los examinados no son independientes. Hay múltiples envíos del mismo modelo con andamiajes distintos, y andamiajes compartidos entre modelos. Eso viola el supuesto de muestreo independiente de la estimación marginal y probablemente subestima los errores estándar de los parámetros de los reactivos.
- El examinado es un sistema compuesto. θ es una propiedad de modelo + andamiaje + presupuesto (intentos, tiempo, costo). No es la “habilidad del modelo”. Comparar θ entre envíos con 1 y con “2+” intentos compara condiciones de administración distintas.
- N pequeño frente a k grande. 173 examinados para 474 reactivos: el Rasch es estable, el 2PL por ML no lo es, y la matriz tetracórica es de rango deficiente. Las cifras de dimensionalidad son descriptivas.
- Calificación y errores de datos. “Sin parche” cuenta como incorrecto, y los resultados dependen de la ejecución de pruebas en contenedores. Excluí dos envíos cuyo archivo por reactivo no coincide con el porcentaje declarado; puede haber otros errores menos visibles. Para algunas corridas, el propio repositorio publica auditorías de trayectorias en las que el agente pudo consultar el historial de git (posible filtración de la solución), lo que añade otra fuente de varianza irrelevante al constructo que esta matriz no permite separar. Además, 6 reactivos dependen del entorno de ejecución (los núcleos del contenedor y la disponibilidad de httpbin.org), y no todos los envíos se evaluaron en las mismas condiciones.
- Contaminación. Los reactivos son issues públicos anteriores al corte de entrenamiento de muchos modelos. Si un sistema “recuerda” la solución, el reactivo mide otra cosa para ese examinado; ningún análisis de esta entrada lo detecta directamente.
Datos, licencia y reproducibilidad
- Matriz de respuestas:
respuestas_swebench_verified.csv (una fila por envío incluido, una columna 0/1 por instance_id).
- Metadatos de envíos y motivos de exclusión:
envios_swebench_verified.csv.
- Entorno de evaluación por envío:
entorno_swebench_verified.csv (núcleos del contenedor según pylint-7277 y respuestas 5xx de httpbin.org en los cuatro reactivos de requests), resumido de los registros públicos del bucket swe-bench-submissions.
- Script de preparación:
preparar_datos.py (Python ≥ 3.9 y PyYAML), que recibe como argumento la ruta a un clon de SWE-bench/experiments.
- Licencias. El repositorio
SWE-bench/experiments no incluye un archivo de licencia en su raíz al momento de la descarga (commit 40f164d); los resultados se usan aquí como datos públicos con atribución a sus autores y a cada equipo que hizo un envío. El código de evaluación de SWE-bench se distribuye bajo licencia MIT. Esta entrada no reproduce el texto de ningún reactivo, solo sus identificadores.
Ver código
sessionInfo()$R.version$version.string
## [1] "R version 4.5.3 (2026-03-11)"
packageVersion("mirt")
## [1] '1.47'
Referencias
American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association.
Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O., & Narasimhan, K. R. (2024). SWE-bench: Can language models resolve real-world GitHub issues? En The Twelfth International Conference on Learning Representations. https://openreview.net/forum?id=VTF8yNQM66
OpenAI. (2024, 13 de agosto). Introducing SWE-bench Verified. https://openai.com/index/introducing-swe-bench-verified/
Yen, W. M. (1984). Effects of local item dependence on the fit and equating performance of the three-parameter logistic model. Applied Psychological Measurement, 8(2), 125–145. https://doi.org/10.1177/014662168400800201